

আপনি কি লক্ষ্য করেছেন সার্চ বক্স কীভাবে টাইপ করার সাথে সাথে শব্দ সাজেস্ট করে? যাহা হোক, অধিকাংশ এই সাজেশনগুলো সিম্পল অ্যালফাবেটিক্যাল অর্ডারে দেখায় এবং সেটা সুপার হেল্পফুল নয়।
কিন্তু কি হয় যদি একটি সার্চ বক্স временем সাথে স্মার্টার হয়?
লোকেরা কী ক্লিক করে সেটা থেকে শিখে এবং সবচেয়ে পপুলার রেজাল্ট প্রথমে দেখায়?
এটাই আমরা বানাবো:
আমরা দেখব কীভাবে Redis Sorted Sets একটি ইন্টেলিজেন্ট অটোকমপ্লিট সিস্টেমকে পাওয়ার দেয় যা ইউজার বিহেভিয়র থেকে শিখে এবং সময়ের সাথে আরও সঠিক হয়ে যায় (পপুলার রেজাল্ট আগে দেখায়)।
স্মার্ট অটোকমপ্লিট সিস্টেমের ধারণা
একটি বেসিক সার্চ বক্স প্রিফিক্স ম্যাচিং নামক একটি মেথড ব্যবহার করে ডিসাইড করে কোন রেজাল্টগুলো প্রথমে দেখাবে।
আপনি টাইপ করার সাথে সাথে, এটি ম্যাচগুলো A-Z অর্ডারে দেখায়। এটা আসলে কোর না যে লোকেরা কোন রেজাল্ট সবচেয়ে বেশি ক্লিক করে।
আমরা এটাকে স্মার্ট করব। আমাদের সার্চ বক্স লোকেরা কী চয়স করে সেটা থেকে শিখবে। যখন লোকেরা একটি সার্চ রেজাল্টে ক্লিক করে, আমরা সেটাকে পরবর্তীবার আগে দেখাব।
এই মানে আমাদের সার্চ সময়ের সাথে সাথে ভালো এবং হেল্পফুল হয়ে যায় অটোমেটিক্যালি সবচেয়ে পপুলার রেজাল্টগুলো টপে দেখিয়ে।
সার্চ অ্যাপ্লিকেশনের জন্য এটি কেন গুরুত্বপূর্ণ
একটি মুভি সার্চ অ্যাপ্লিকেশন বিবেচনা করুন: যখন ইউজাররা "int" টাইপ করে। তারা দেখতে পায়:
- "Interceptor"
- "Interstate 60"
- "Interstellar"
একটি "ট্র্যাডিশনাল" সিস্টেমে, এগুলো অ্যালফাবেটিক্যালি আসবে। যাইহোক, যদি ইউজাররা কনসিস্টেন্টলি "Interstellar"-এ ক্লিক করে, তবে আমরা সেটাকে অটোকমপ্লিট সাজেশনের টপে প্রোমোট করতে চাই।
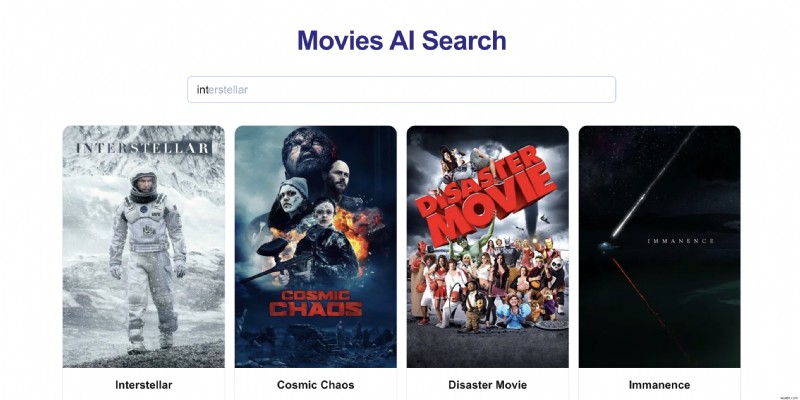
এই স্মার্ট র্যাঙ্কিং সিস্টেম খুব ভালো কাজ করে:
- স্ট্রিমিং সার্ভিস যেন Netflix বা YouTube সবচেয়ে বেশি যা দেখা হয় সেটা আগে দেখাতে
- অনলাইন স্টোর সার্চ করার সময় পপুলার প্রোডাক্ট প্রথমে দেখাতে
- হেল্প সেন্টার সবচেয়ে कॉमन প্রশ্নগুলো লোকেরা পুঁछे সেটা আগে দেখাতে
- সার্চ সহ যেকোনো ওয়েবসাইট সবচেয়ে বেশি যা ক্লিক হয় সেটা প্রথমে দেখাতে
Redis Sorted Sets বোঝা
চলে বুঝি কেন Redis Sorted Sets অটোকমপ্লিট সিস্টেম বানাতে চমৎকার।
একটি Redis Sorted Set যেন একটি স্মার্ট লিস্ট যেটা:
- প্রতিটি আইটেম ইউনিক (সেটের মত)
- প্রতিটি আইটেমের একটি স্কোর থাকে (অর্ডারিং-এর জন্য)
- আইটেমগুলো দ্রুত তাদের স্কোর অনুযায়ী সোর্টেড হতে পারে
আমাদের অটোকমপ্লিট সিস্টেমের জন্য, আমরা দুটি সোর্টেড সেট ব্যবহার করব:
- একটি টেক্সট প্রিফিক্স ম্যাচ করার জন্য (যেন "int" "interstellar"-এর সাথে ম্যাচ করে)
- আরেকটি প্রতিটি সাজেশন কতটুকু পপুলার সেটা ট্র্যাক করার জন্য
এই দুটি সেট একসাথে কাজ করে ইউজার টাইপ করার সাথে সাথে সবচেয়ে রিলেভান্ট রেজাল্ট সাজেস্ট করতে।
ফাউন্ডেশন: অ্যালফাবেটিক্যাল অর্ডারিং
Redis Sorted Sets অ্যালফাবেটিক্যাল অর্ডারিং মেইনটেইন করে যখন সব মেম্বারের একই স্কোর থাকে। এটি সার্চ সাজেশন বানাতে পায়ারফেক্ট কারণ এটি আমাদের দেয়:
- সকল প্রিফিক্স স্টোর করুন সার্চেবল টার্মের একটি সিঙ্গেল ডেটা স্ট্রাকচারে
ZRANKব্যবহার করুন যেকোনো প্রিফিক্সের স্ট্রাটিং পজিশন O(log N) টাইমে খুঁজে বের করতেZSCANব্যবহার করুন সেটা পজিশন থেকে শুরু করে সব ম্যাচ দক্ষতার সাথে রিট্রিভ করতেZMSCOREব্যবহার করুন প্রতিটি ম্যাচের পপুলারিটি স্কোর পেতেZINCRBYব্যবহার করুন প্রতিটি ম্যাচের পপুলারিটি স্কোর ইনক্রিমেন্ট করতে
একটি সিম্পল উদাহরণ দেখি। যখন আমরা "INTERSTELLAR" মুভি আমাদের সার্চ সিস্টেমে অ্যাড করি, আমরা এটাকে এইভাবে ব্রেক ডাউন করি:
- Score: 0, Member: "I"
- Score: 0, Member: "IN"
- Score: 0, Member: "INT"
- Score: 0, Member: "INTE"
- Score: 0, Member: "INTER"
- Score: 0, Member: "INTERSTELLAR$Interstellar" (কমপ্লিট এন্ট্রি ডিসপ্লে ফরম্যাটে)
দেখুন কীভাবে আমরা $ ব্যবহার করি সার্চ ভার্সনকে ডিসপ্লে ভার্সন থেকে আলাদা করার জন্য? এইভাবে, ইউজাররা আপারকেস বা লোয়ারকেস চিন্তা না করে সার্চ করতে পারে, কিন্তু আমরা মুভি টাইটেলটি ঠিক যেমন দেখানো উচিত সেভাবে দেখাই।
আমরা ডেটা কীভাবে স্টোর করি
আমরা দুটি Redis সোর্টেড সেট ব্যবহার করি আমাদের অটোকমপ্লিট কাজ করার জন্য:
১. মুভি টাইটেল লিস্ট
চলে একটি সোর্টেড সেট যেটা movies নামে থাকবে ট্র্যাক করি। এটাকে যেন একটি ডিকশনারি ভাবুন যা আমাদের মুভি দ্রুত খুঁজে বের করতে সাহায্য করে। কেউ "int" টাইপ করলে, আমরা ইনস্ট্যান্টলি সকল মুভি খুঁজে পেতে পারি যেগুলো সেই লেটার দিয়ে শুরু হয়।
"int"-এর প্রথম অকারেন্স ZRANK-এ 의해 খুঁজে বের হবে এবং তারপর সেই পজিশন থেকে ফুল মুভি নাম `INT*$* ワイル্ডকার্ড দিয়ে ফেচ হবে।
২. পপুলার মুভি লিস্ট
চলে আরেকটি সোর্টেড সেট যেটা movie-popularity নামে থাকবে ট্র্যাক করি। এটি আমাদের "ট্রেন্ডিং মুভি" লিস্ট।
প্রতিবার কেউ সার্চ রেজাল্টে একটি মুভিতে ক্লিক করে, সেই মুভিটি আরও পপুলার হয় এর স্কোর ZINCRBY দিয়ে এক করে বৃদ্ধি পায়। সবচেয়ে বেশি ক্লিক হওয়া মুভিগুলো ভবিষ্যতের সার্চে আগে দেখাবে।
এটা যেন Netflix কীভাবে ট্রেন্ডিং মুভি দেখায় - যত বেশি লোক কিছু দেখে, তত বেশি সেটা রিকমেন্ডেশন-এ উপরে আসে।
আমাদের কেসে, `INT*$* এর এক্স্যাক্ট ম্যাচগুলো খুঁজে পাওয়ার পর, আমরা যাই movie-popularity-এ তাদের স্কোর চেক করতে যেন সবচেয়ে পপুলারগুলো পাই।
অ্যালগোরিদমিক ফ্লো
graph TD
A[User types 'int'] --> B[ZRANK: Find lexicographic position of 'INT']
B --> C[ZSCAN: Retrieve matches starting from position (movies set)]
C --> D[Filter: Extract complete terms containing '$']
D --> E[ZMSCORE: Get popularity scores for all matches (movie-popularity set)]
E --> F[Rank: Return highest-scored suggestion]
G[User selects suggestion] --> H[ZINCRBY: Increment popularity score]
H --> I[Future searches: Higher scored items rank first]
I --> A
যেমতে ইউজাররা সার্চ এবং সাজেশনে ক্লিক করে, সিস্টেম শিখে এবং উন্নত হয়। যত বেশি লোক এটি ব্যবহার করে, তত ভালো হয়ে যায় এটি সবচেয়ে রিলেভান্ট সাজেশন প্রথমে দেখাতে।
চলে অটোকমপ্লিট সিস্টেম বানাই
চলে এই অটোকমপ্লিট সিস্টেমকে ধাপে ধাপে কীভাবে বানানো হয় সেটা দেখি। আমরা এটা সুপার সিম্পল রাখব!
স্টেপ ১: মুভি টাইটেল Redis-এ যোগ করা
প্রথমে, আমাদের মুভি টাইটেলগুলো Redis-এ যোগ করতে হবে যাতে পরে সার্চ করতে পারি। আপনি যেকোনো জায়গা থেকে একটি সিম্পল মুভি লিস্ট দিয়ে শুরু করতে পারেন - হয় আপনার ডাটাবেস থেকে বা শুধু একটি টেক্সট ফাইল। এখানে কীভাবে আমরা সেগুলো অ্যাড করি:
import { Redis } from "@upstash/redis";
const redis = new Redis({
  url: process.env.UPSTASH_REDIS_URL!,
  token: process.env.UPSTASH_REDIS_TOKEN!,
});
// উদাহরণ: আপনার টাইটেলের লিস্ট
const titles = [
  "Interceptor",
  "Interstate 60",
  "Interstellar",
  // ... আরও টাইটেল
];
async function populateAutocomplete() {
  // 'movies' সোর্টেড সেটে প্রিফিক্স এবং ফুল টাইটেল ইনসার্ট করুন
  for (const title of titles) {
    let term = title.toUpperCase();
    let terms = [];
    for (let i = 1; i < term.length; i++) {
      terms.push({ score: 0, member: term.substring(0, i) });
    }
    terms.push({ score: 0, member: term });
    terms.push({ score: 0, member: term + "$" + title });
    await redis.zadd("movies", ...terms);
  }
  // 'movie-popularity' সোর্টেড সেটে সব টাইটেল ইনসার্ট করুন পপুলারিটি ট্র্যাক করার জন্য
  await redis.zadd(
    "movie-popularity",
    ...titles.map((title) => ({
      score: 0,
      member: title.toUpperCase(),
    })),
  );
}
populateAutocomplete();
উপরের কোডটি কী করে সেটা ব্রেক ডাউন করি:
-
প্রতিটি মুভি টাইটেলের জন্য, আমরা স্টোর করি:
- সকল সম্ভাব্য পারশিয়াল ম্যাচ (যেন "INT", "INTE", "INTER" "Interstellar"-র জন্য)
- কমপ্লিট টাইটেলটি নিজে
- ডিসপ্লে করার জন্য একটি ফরম্যাটেড ভার্সন
-
আমরা আলাদা একটি লিস্টও তৈরি করি যা প্রতিটি মুভি কতটুকু পপুলার সেটা ট্র্যাক করে, শূন্য ভিউ দিয়ে শুরু করে
এটি আমাদের সবকিছু দেয় যা ইউজার টাইপ করার সাথে সাথে স্মার্ট সাজেশন দেখাতে এবং সেগুলো যেসব ক্লিক করে সেটা থেকে শিখতে।
স্টেপ ২: সেরা ম্যাচ খুঁজে বের করা
পরে, আমরা দেখব কীভাবে আমরা এই মুভি টাইটেলগুলো সার্চ করে ম্যাচ খুঁজে বের করি। আমাদের matchQuery ফাংশনটি সব ভারী কাজ করে:
export const matchQuery = async (query: string): Promise<string | null> => {
  const upperQuery = query.toUpperCase();
  // Step 1: লেক্সিকোগ্রাফিক অর্ডারিং ব্যবহার করে স্ট্রাটিং পজিশন খুঁজুন
  let rank = await redis.zrank("movies", upperQuery);
  if (rank === null) return null;
  // Step 2: সেই পজিশন থেকে দক্ষতার সাথে ম্যাচের জন্য স্ক্যান করুন
  const scanResult = await redis.zscan("movies", rank, {
    match: `${upperQuery}*$*`,
    count: 1000,
  });
  // Step 3: কমপ্লিট এন্ট্রি এক্সট্র্যাক্ট করুন এবং তাদের পপুলারিটি স্কোর পান
  const completeTitles = scanResult[1].filter(
    (el, idx) => idx % 2 === 0 && el.includes("$"),
  );
  const baseNames = completeTitles.map((title) => title.split("$")[0]);
  const scores = await redis.zmscore("movie-popularity", baseNames);
  // Step 4: হাইএস্ট-স্কোরড (সবচেয়ে পপুলার) ম্যাচ রিটার্ন করুন
  const maxScore = Math.max(...scores);
  const bestMatchIndex = scores.indexOf(maxScore);
  return completeTitles[bestMatchIndex].split("$")[1];
};
ইউজার চয়স থেকে শিখা
যখন কেউ একটি মুভি টাইটেল সিলেক্ট করে, আমরা এর স্কোরে ১ পয়েন্ট যোগ করি। বেশি পয়েন্ট 가진 মুভিগুলো সাজেশন লিস্টে উপরে দেখাবে। সেটা ততটুকু সহজ!
সিস্টেম সময়ের সাথে সাথে স্মার্ট হয়ে যায় লোকরা আসলে কী চয়স করে সেটা ট্র্যাক করে।
const onSubmit = async (title: string) => {
  // সাবমিট লজিক হ্যান্ডল করুন এখানে
  await redis.zincrby("movie-popularity", 1, title.toUpperCase());
};
এটা কত দ্রুত?
চলে এই সমাধানটি কত দ্রুত সেটা দেখি প্রতিটি অপারেশন কত টাইম নেয় সেটা ব্রেক ডাউন করে:
- ZRANK: O(log N) - লগারিদমিক লুকআপ টাইম
- ZSCAN: O(log N + M) - যেখানে M হলো রিটার্নড এলিমেন্টের সংখ্যা
- ZMSCORE: O(N) - যেখানে N হলো ম্যাচড রেজাল্টের সংখ্যা, টোটাল ডেটাসেট সাইজ নয়
- ZINCRBY: O(log N) - এটমিক ইনক্রিমেন্ট লগারিদমিক কমপ্লেক্সিটির সাথে
আমরা বেশি মুভি টাইটেল যোগ করলেও, পারফরম্যান্স কনসিস্টেন্ট থাকে।
উপসংহার: আমরা একসাথে কী বানালাম
আপনি শিখেছেন কীভাবে একটি স্মার্ট সার্চ বক্স বানাতে হয় যেটি কোনো AI ছাড়া সময়ের সাথে সাথে ভালো হয়ে যায়!
আমাদের অটোকমপ্লিট লোকেরা কী চয়স করে সেটা থেকে শিখে এবং সেই ইনফরমেশন ব্যবহার করে ভালো সাজেশন দেখায়।
এটা ফাস্ট, সিম্পল, এবং মানুষ যত বেশি ব্যবহার করে তত বেশি হেল্পফুল হয়ে যায়।
Redis অপ্টিমাইজেশন কৌশল বা আপনার নিজস্ব ইমপ্লিমেন্টেশন শেয়ার করতে চান? Discord-এ আমাদের সাথে যোগ দিন!
