

এই আর্টিকেলে আমি তিনটি সার্ভারলেস ডেটাবেস DynamoDB, FaunaDB, Upstash (Redis)-এর লেটেন্সি একটি সাধারণ ওয়েব ইউজ কেসের জন্য তুলনা করব।
আমি একটি নমুনা নিউজ ওয়েবসাইট তৈরি করেছি এবং প্রতিটি রিকোয়েস্টে ডেটাবেস-রিলেটেড লেটেন্সি রেকর্ড করছি। ওয়েবসাইট এবং সোর্স কোড চেক করুন।
প্রতিটি ডেটাবেসে ৭,০০১টি NY Times আর্টিকেল ইনসার্ট করেছি। আর্টিকেলগুলো নিউইয়র্ক টাইম্স Archive API- থেকে সংগৃহীত (২০২১ জানুয়ারির সব আর্টিকেল)। প্রতিটি আর্টিকেলকে র্যান্ডমলি স্কোর করেছি। প্রতিটি পেজ রিকোয়েস্টে, প্রতিটি ডেটাবেস থেকে World সেকশনের অধীনে শীর্ষ ১০ আর্টিকেল কোয়েরি করি।
আর্টিকেল লোড করতে সার্ভারলেস ফাংশন (AWS Lambda) ব্যবহার করি। ১০টি আর্টিকেল ফেচ করার রেসপন্স টাইম লেটেন্সি হিসেবে ল্যাম্বডা ফাংশনের ভিতরে রেকর্ড করা হয়। মনে রাখবেন রেকর্ড করা লেটেন্সি শুধু ল্যাম্বডা ফাংশন এবং ডেটাবেসের মধ্যবর্তী। এটি আপনার ব্রাউজার এবং সার্ভারের মধ্যবর্তী লেটেন্সি নয়।
প্রতিটি রিড রিকোয়েস্টের পর, ডাইনামিক ডেটা অনুকরণ করতে স্কোরগুলো র্যান্ডমলি আপডেট করি। কিন্তু এই অংশ লেটেন্সি ক্যালকুলেশন থেকে বাদ রেখেছি।
প্রথমে অ্যাপ্লিকেশনটি পরীক্ষা করব, তারপর ফলাফল দেখব:
AWS Lambda সেটআপ
- রিজন: US-West-1
- মেমরি: 1024Mb
- রানটাইম: nodejs14.x
DynamoDB সেটআপ
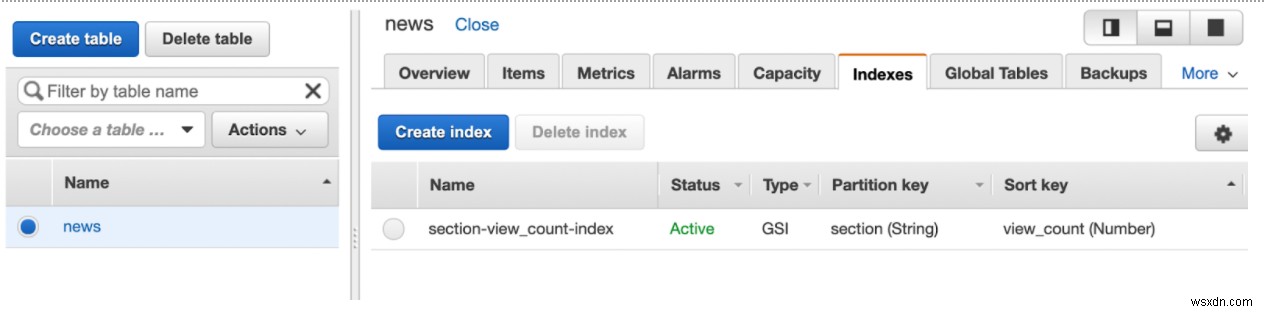
US-West-1-এ DynamoDB টেবিল তৈরি করেছি রিড এবং রাইট ক্যাপাসিটি ৫০ (ডিফল্ট ৫)।
আমার ইন্ডেক্স GSI with partition key section (String) and sort key view_count (Number)।
FaunaDB সেটআপ
FaunaDB একটি গ্লোবালি রেপ্লিকেটেড ডেটাবেস, আমার জানা মতে রিজন সিলেক্ট করার উপায় নেই। FQL ব্যবহার করেছি, ধরে নিচ্ছি GraphQL API-তে কিছু ওভারহেড থাকতে পারে।
section terms এবং ref values দিয়ে একটি ইন্ডেক্স তৈরি করেছি। পারফরম্যান্স উন্নত করার আশায় নন-সিরিয়ালাইজড রেখেছি।
CreateIndex({
  name: "section_by_view_count",
  unique: false,
  serialized: false,
  source: Collection("news"),
  terms: [ { field: ["data", "section"] } ],
  values: [
    { field: ["data", "view_count"], reverse: true },
    { field: ["ref"] }
  ]
})
Redis সেটআপ
Upstash-এ US-West-1 রিজনে Standard টাইপ ডেটাবেস তৈরি করেছি। প্রতিটি নিউজ ক্যাটাগরির জন্য একটি Sorted Set ব্যবহার করেছি। সকল World নিউজ আর্টিকেল World কি দিয়ে Sorted Set-এ থাকবে।
ডেটাবেস ইনিশিয়ালাইজ
NYTimes API সাইট থেকে ৭,০০১টি নিউজ আর্টিকেল JSON ফাইল হিসেবে ডাউনলোড করেছি, তারপর প্রতিটি ডেটাবেসের জন্য একটি NodeJS স্ক্রিপ্ট তৈরি করেছি যা JSON পড়ে নিউজ রেকর্ড ডেটাবেসে ইনসার্ট করে। ফাইলগুলো: initDynamo.js, initFauna.js, initRedis.js।
DynamoDB কোয়েরি
DynamoDB-এ কানেক্ট করার জন্য AWS SDK ব্যবহার করেছি। লেটেন্সি ন্যূনতম করতে DynamoDB কানেকশন alive রাখা হয়েছে। Response time মাপার জন্য perf_hooks লাইব্রেরি ব্যবহার করেছি। DynamoDB-এ শীর্ষ ১০ আর্টিকেল কোয়েরি করার ঠিক আগে করেন্ট টাইম রেকর্ড করেছি। DynamoDB থেকে রেসপন্স পাওয়ার সাথে সাথে লেটেন্সি ক্যালকুলেট করেছি। তারপর আর্টিকেলগুলোর র্যান্ডম স্কোর দিয়ে লেটেন্সি নম্বর Redis sorted set-এ পুশ করেছি কিন্তু এই অংশ লেটেন্সি ক্যালকুলেশন পার্টের বাইরে। কোড নিচে:
var AWS = require("aws-sdk");
AWS.config.update({ region: "us-west-1" });
const https = require("https");
const agent = new https.Agent({ keepAlive: true, maxSockets: Infinity });
AWS.config.update({ httpOptions: { agent } });
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const tableName = "news";
var params = {
  TableName: tableName,
  IndexName: "section-view_count-index",
  KeyConditionExpression: "#sect = :section",
  ExpressionAttributeNames: { "#sect": "section" },
  ExpressionAttributeValues: { ":section": process.env.SECTION },
  Limit: 10,
  ScanIndexForward: false,
};
const docClient = new AWS.DynamoDB.DocumentClient();
module.exports.load = (event, context, callback) => {
  let start = performance.now();
  docClient.query(params, (err, result) => {
    if (err) {
      console.error("Unable to scan the table. Error JSON:", JSON.stringify(err, null, 2));
    } else {
      let latency = performance.now() - start;
      let response = {
        statusCode: 200,
        headers: {
          "Access-Control-Allow-Origin": "*",
          "Access-Control-Allow-Credentials": true,
        },
        body: JSON.stringify({ latency: latency, data: result }),
      };
      result.Items.forEach((item) => {
        let view_count = Math.floor(Math.random() * 1000);
        var params2 = {
          TableName: tableName,
          Key: { id: item.id },
          UpdateExpression: "set view_count = :r",
          ExpressionAttributeValues: { ":r": view_count },
        };
        docClient.update(params2, function (err, data) {
          if (err) { console.error("Unable to update item. Error JSON:", JSON.stringify(err, null, 2)); }
        });
      });
      const client = new Redis(process.env.LATENCY_REDIS_URL);
      client.lpush("histogram-dynamo", latency, (resp) => { client.quit(); callback(null, response); });
    }
  });
};
FaunaDB কোয়েরি
FaunaDB-এ কানেক্ট ও কোয়েরি করার জন্য faunadb লাইব্রেরি ব্যবহার করেছি। বাকি অংশ DynamoDB কোডের মতো। কানেকশন alive রেখেছি। perf_hooks দিয়ে রেসপন্স টাইম মাপা হয়েছে। FaunaDB-এ শীর্ষ ১০ আর্টিকেল কোয়েরি করার ঠিক আগে টাইম রেকর্ড, রেসপন্স পাওয়ার পর লেটেন্সি ক্যালকুলেট। তারপর র্যান্ডম স্কোর দিয়ে লেটেন্সি Redis sorted set-এ পাঠানো। কোড:
const faunadb = require("faunadb");
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const q = faunadb.query;
const client = new faunadb.Client({ secret: process.env.FAUNA_SECRET, keepAlive: true });
const section = process.env.SECTION;
module.exports.load = async (event) => {
  let start = performance.now();
  let ret = await client.query(
    q.Map(
      q.Paginate(q.Match(q.Index("section_by_view_count"), section), { size: 10 }),
      q.Lambda(["view_count", "X"], q.Get(q.Var("X")))
    )
  ).catch((err) => console.error("Error: %s", err));
  console.log(ret);
  let latency = performance.now() - start;
  const rclient = new Redis(process.env.LATENCY_REDIS_URL);
  await rclient.lpush("histogram-fauna", latency);
  await rclient.quit();
  let result = [];
  for (let i = 0; i < ret.data.length; i++) { result.push(ret.data[i].data); }
  ret.data.forEach((item) => {
    let view_count = Math.floor(Math.random() * 1000);
    client.query(q.Update(q.Ref(q.Collection("news"), item["ref"].id), { data: { view_count } })).catch((err) => console.error("Error: %s", err));
  });
  return {
    statusCode: 200,
    headers: { "Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": true },
    body: JSON.stringify({ latency: latency, data: { Items: result } }),
  };
};
Redis কোয়েরি
Upstash-এ Redis-এ কানেক্ট ও রিডের জন্য ioredis লাইব্রেরি ব্যবহার করেছি। Sorted Set থেকে ডেটা লোড করতে ZREVRANGE কমান্ড। লেটেন্সি ন্যূনতম করতে কানেকশন রিয়ুজ করেছি (ফাংশনের বাইরে Redis ক্লায়েন্ট তৈরি)। DynamoDB এবং FaunaDB-এর মতোই স্কোর আপডেট এবং লেটেন্সি অন্য Redis DB-এ পাঠানো। কোড:
const Redis = require("ioredis");
const { performance } = require("perf_hooks");
const client = new Redis(process.env.REDIS_URL);
module.exports.load = async (event) => {
  let section = process.env.SECTION;
  let start = performance.now();
  let data = await client.zrevrange(section, 0, 9);
  let items = [];
  for (let i = 0; i < data.length; i++) { items.push(JSON.parse(data[i])); }
  let latency = performance.now() - start;
  for (let i = 0; i < data.length; i++) {
    let view_count = Math.floor(Math.random() * 1000);
    await client.zadd(section, view_count, data[i]);
  }
  const client2 = new Redis(process.env.LATENCY_REDIS_URL);
  await client2.lpush("histogram-redis", latency);
  await client2.quit();
  return {
    statusCode: 200,
    headers: { "Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": true },
    body: JSON.stringify({ latency: latency, data: { Items: items } }),
  };
};
হিস্টোগ্রাম ক্যালকুলেশন
হিস্টোগ্রাম ক্যালকুলেট করতে hdr-histogram-js লাইব্রেরি ব্যবহার করেছি। এটি Gil Tene-এর hdr-histogram library-র JS ইমপ্লিমেন্টেশন। লেটেন্সি নম্বর রিসিভ করে হিস্টোগ্রাম ক্যালকুলেট করার ল্যাম্বডা ফাংশন কোড:
const Redis = require("ioredis");
const hdr = require("hdr-histogram-js");
module.exports.load = async (event) => {
  const client = new Redis(process.env.LATENCY_REDIS_URL);
  let dataRedis = await client.lrange("histogram-redis", 0, 10000);
  let dataDynamo = await client.lrange("histogram-dynamo", 0, 10000);
  let dataFauna = await client.lrange("histogram-fauna", 0, 10000);
  const hredis = hdr.build();
  const hdynamo = hdr.build();
  const hfauna = hdr.build();
  dataRedis.forEach((item) => { hredis.recordValue(item); });
  dataDynamo.forEach((item) => { hdynamo.recordValue(item); });
  dataFauna.forEach((item) => { hfauna.recordValue(item); });
  await client.quit();
  return {
    statusCode: 200,
    headers: { "Access-Control-Allow-Origin": "*", "Access-Control-Allow-Credentials": true },
    body: JSON.stringify({
      redis_min: hredis.minNonZeroValue, dynamo_min: hdynamo.minNonZeroValue, fauna_min: hfauna.minNonZeroValue,
      redis_mean: hredis.mean, dynamo_mean: hdynamo.mean, fauna_mean: hfauna.mean,
      redis_histogram: hredis, dynamo_histogram: hdynamo, fauna_histogram: hfauna,
    }, null, 2),
  };
};
ফলাফল
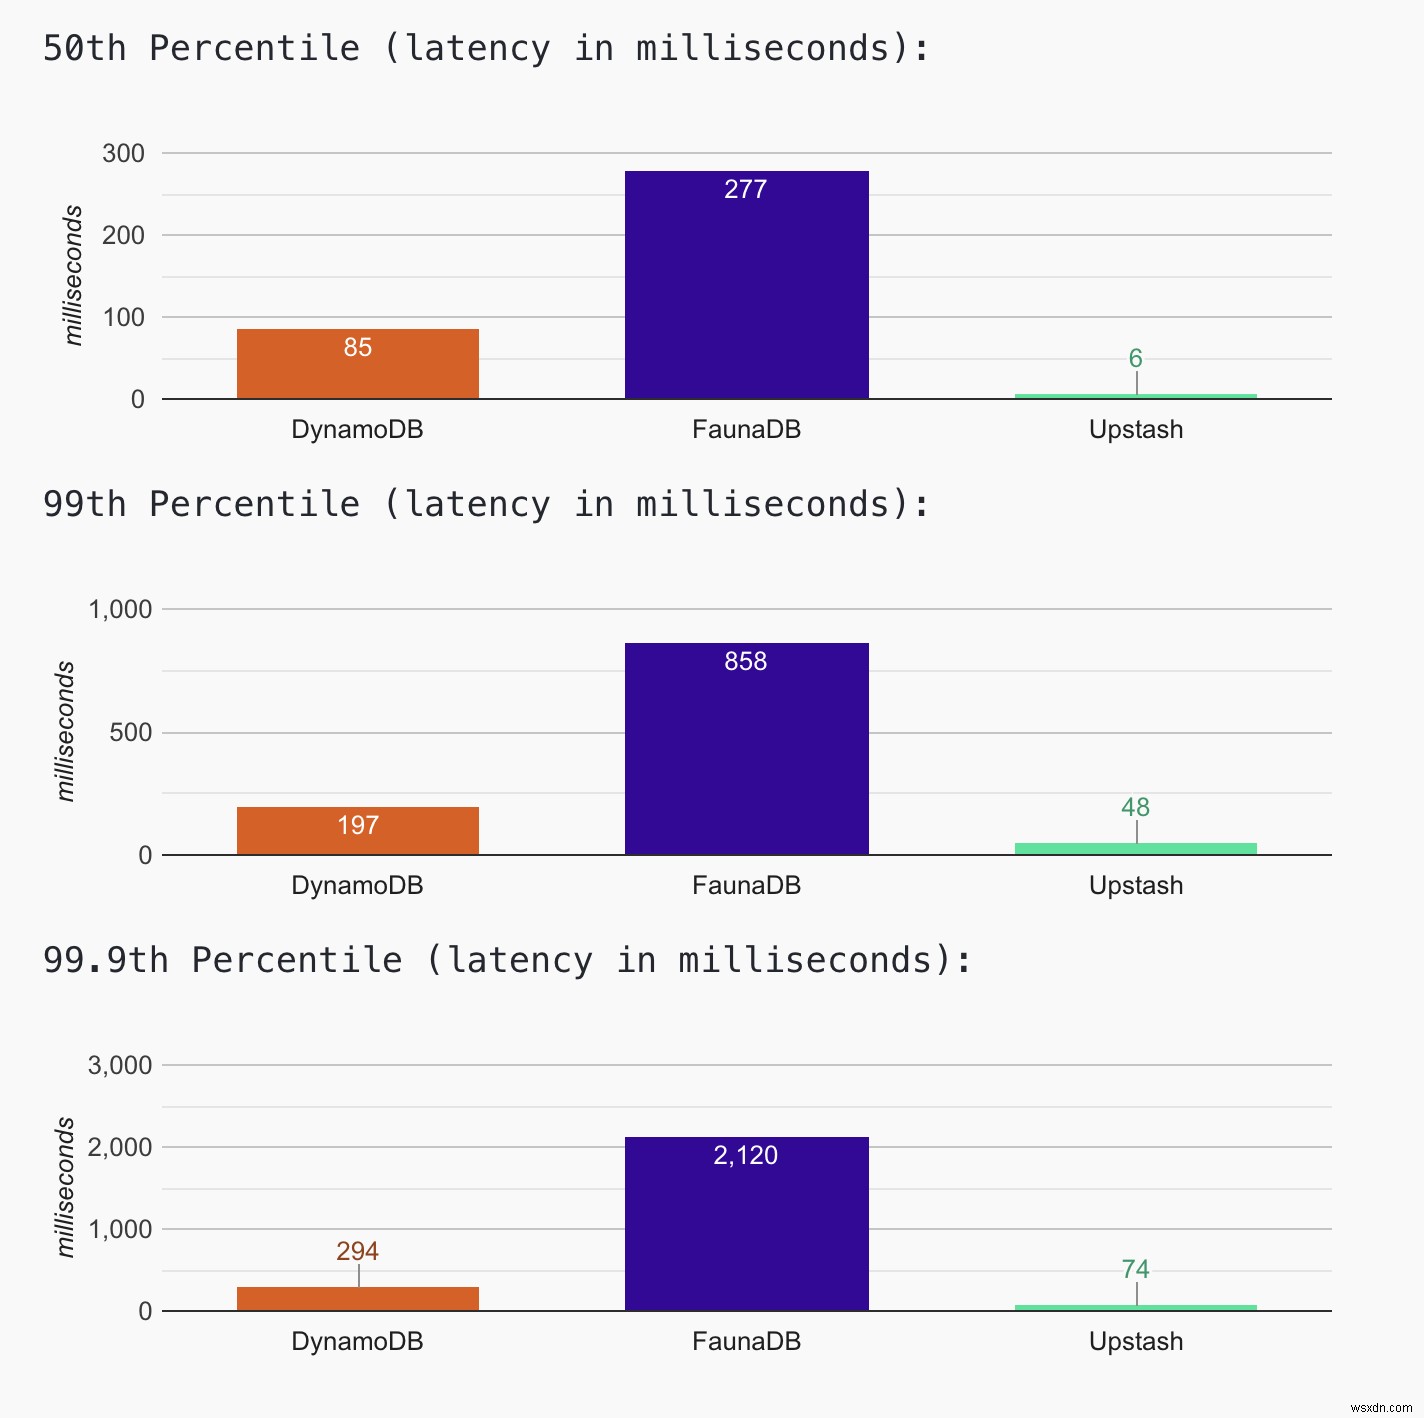
ওয়েবসাইট-এ লেটেস্ট ফলাফল চেক করুন। লেটেস্ট হিস্টোগ্রাম ডেটা-ও পেতে পারেন। ওয়েবসাইট চলে থাকা পর্যন্ত ডেটা কালেক্ট করা হবে এবং হিস্টোগ্রাম আপডেট হবে। আজ (এপ্রিল ১২, ২০২১) পর্যন্ত ফলাফল দেখাচ্ছে Upstash-এর লেটেন্সি সবচেয়ে কম (~৫০ms at 99th percentile), FaunaDB-এর সবচেয়ে বেশি (~৯০০ms at 99th percentile), DynamoDB ~২০০ms at 99th percentile।
কোল্ড স্টার্ট ইফেক্ট
হालांकि আমরা কোয়েরি পার্টের লেটেন্সি মাপি, কোল্ড স্টার্টর প্রভাব থাকে। আমরা ক্লায়েন্ট কানেকশন রিয়ুজ করে কোড অপ্টিমাইজ করেছি। এটি সুবিধা দেয় যতক্ষণ না AWS কন্টেইনার কিল করে (কোল্ড স্টার্ট)। অ্যাপ্লিকেশন ওয়েবসাইটে পেজ রিফ্রেশ করলে লেটেন্সি নম্বর Upstash-এ ~১ms এবং DynamoDB-এ ~৭ms পর্যন্ত নামতে দেখবেন।
এই বেঞ্চмар্কে FaunaDB ধীর কেন?
FaunaDB-এর স্ট্যাটাস পেজে লেটেন্সি নম্বর সেকেন্ডে সেকেন্ডে দেখতে পাবেন। তাই আমি ধরে নিচ্ছি আমার কনফিগারেশনে বড় ফ্ল না। লেটেন্সি পার্থক্যের দুটি কারণ হতে পারে:
স্ট্রং কনসিস্টেন্সি: ডিফল্টভাবে DynamoDB এবং Upstash রিডের জন্য eventual consistency দেয়। FaunaDB Calvin-ভিত্তিক স্ট্রং কনসিস্টেন্সি এবং আইসোলেশন দেয়। স্ট্রং কনসিস্টেন্সি পারফরম্যান্স ওভারহেড নিয়ে আসে।
গ্লোবাল রেপ্লিকেশন: Upstash এবং DynamoDB-এ ডেটাবেস এবং ল্যাম্বডা একই AWS রিজনে কনফিগার করা যায়। FaunaDB-এ ডেটা সারাবিশ্বে রেপ্লিকেটেড, তাই আপনার রিজন পিক করার অপশন নেই। যদি আপনার ডেটাবেস ক্লায়েন্ট সারাবিশ্বে থাকে তবে এটি সুবিধা। কিন্তু ব্যাকএন্ড নির্দিষ্ট রিজনে ডিপ্লয় করলে এটা এক্সট্রা লেটেন্সি সৃষ্টি করে।
Redis সাব-মিলিসেকেন্ড লেটেন্সি দেয়। এখানে কেন নয়?
AWS Lambda ফাংশনে নতুন Redis কানেকশন তৈরি করলে নোটেবল ওভারহেড হয়। অ্যাপ্লিকেশনে স্থিতিশীল ট্রাফিক না থাকায় AWS Lambda অধিকাংশ সময় কানেকশন রি-ক্রিয়েট করে (কোল্ড স্টার্ট)। তাই হিস্টোগ্রামের অধিকাংশ লেটেন্সি নম্বরে কানেকশন ক্রিয়েশন টাইম অন্তর্ভুক্ত। আমরা ১৫ সেকেন্ড अन्तরালে ওয়েবসাইট ফেচ করার একটি জব চালিয়েছি; দেখলাম Upstash-এর লেটেন্সি ~১ms পর্যন্ত নেমেছে। পেজ রিফ্রেশ করলে আপনিও সিমিলার ইফেক্ট দেখবেন। আমাদের ব্লগ পোস্ট দেখুন সার্ভারলেস অ্যাপ লো লেটেন্সির জন্য অপ্টিমাইজ করার পদ্ধতি।
coming Soon
Upstash শীঘ্রই Premium প্রোডাক্ট রিলিজ করবে যেখানে ডেটা একাধিক availability zone-এ রেপ্লিকেট হবে। সেটি যোগ করব জোন রেপ্লিকেশনের ইফেক্ট দেখতে।
আপনার ফিডব্যাক জানান Twitter বা Discord-এ।
আপডেট
HackerNews-এ আমার বেঞ্চмар্ক এবং Fauna পারফরম্যান্স নিয়ে সক্রিয় আলোচনা ছিল। সাজেশনগুলো অ্যাপ্লাই করে FaunaDB অ্যাপ্লিকেশন রিস্টার্ট করলাম। তাই হিস্টোগ্রামে FaunaDB রেকর্ডের সংখ্যা অন্যদের চেয়ে কম।
