

এটি এপ্রিল ২০২১-এর ব্লগ পোস্ট-এর অবিচ্ছিন্নতা। আমরা একটি নমুনা অ্যাপ্লিকেশন তৈরি করেছি যা সাধারণ ওয়েব ইউজ কেস এবং সার্ভারলেস ফাংশন ব্যবহার করে অগ্রণী সার্ভারলেস ডেটাবেসগুলির পারফরম্যান্স তুলনা করে। ডেটাবেসগুলো হল: DynamoDB, MongoDB (Atlas), Firestore, Cassandra (DataStax Astra), FaunaDB এবং Redis (Upstash)।
অ্যাপ্লিকেশনটি এবং সোর্স কোড দেখুন।
আমরা প্রতিটি ডেটাবেসের জন্য শীর্ষ ১০টি নিউজ আর্টিকেল আনতে কত লেটেন্সি লাগে তা তুলনা করেছি। মোট ডেটা হল নিউയর্ক টাইম্স API থেকে সংগৃহীত ৭,০০১টি আসল নিউজ আর্টিকেল। আমরা যে কোয়েরটির লেটেন্সি পরিমাপ করেছি সেটি হল:
select * from news where section = "World" order by view_count desc limit 10ব্যাকএন্ডটি AWS Lambda-তে সার্ভারলেস ফাংশন হিসেবে پیادهسازی করা হয়েছে (Firestore-এর জন্য Google Cloud Function)। লেটেন্সি ন্যূনতম রাখতে সার্ভারলেস ফাংশন এবং ডেটাবেস একই রিজনে রাখা হয়েছে (যতটুকু সম্ভব)।
লেটেন্সি পরিমাপে ডেটাবেস কানেকশন সময় বাদ দেওয়া হয়েছে; কোয়েরি করার ठीक আগে এবং পরে টাইমস্ট্যাম্প রেকর্ড করা হয়েছে। লেটেন্সি ব্যাকএন্ডে (সার্ভারলেস ফাংশনের ভিতরে) পরিমাপ করা হয়েছে, তাই ব্রাউজার এবং সার্ভারের মধ্যবর্তী নেটওয়ার্ক লেটেন্সি এতে অন্তর্ভুক্ত নয়। সার্ভারলেস ফাংশনের কোল্ড স্টার্ট টাইমও লেটেন্সিকে প্রভাবিত করে না।
ডাইনামিক রিয়েল-ওয়ার্ল্ড ডেটা অনুকরণ করতে, শীর্ষ ১০টি আর্টিকেলের জন্য র্যান্ডম view_count মান नियোজিত করা হয়েছে। প্রতিবার ডেটাবেসকে ভিন্ন সেট আর্টিকেল রিটার্ন করতে বাধ্য করা হয়েছে যাতে ক্যাশ ব্যবহার না করতে পারে। আপডেট অপারেশন লেটেন্সি ক্যালকুলেশনে অন্তর্ভুক্ত নয়।
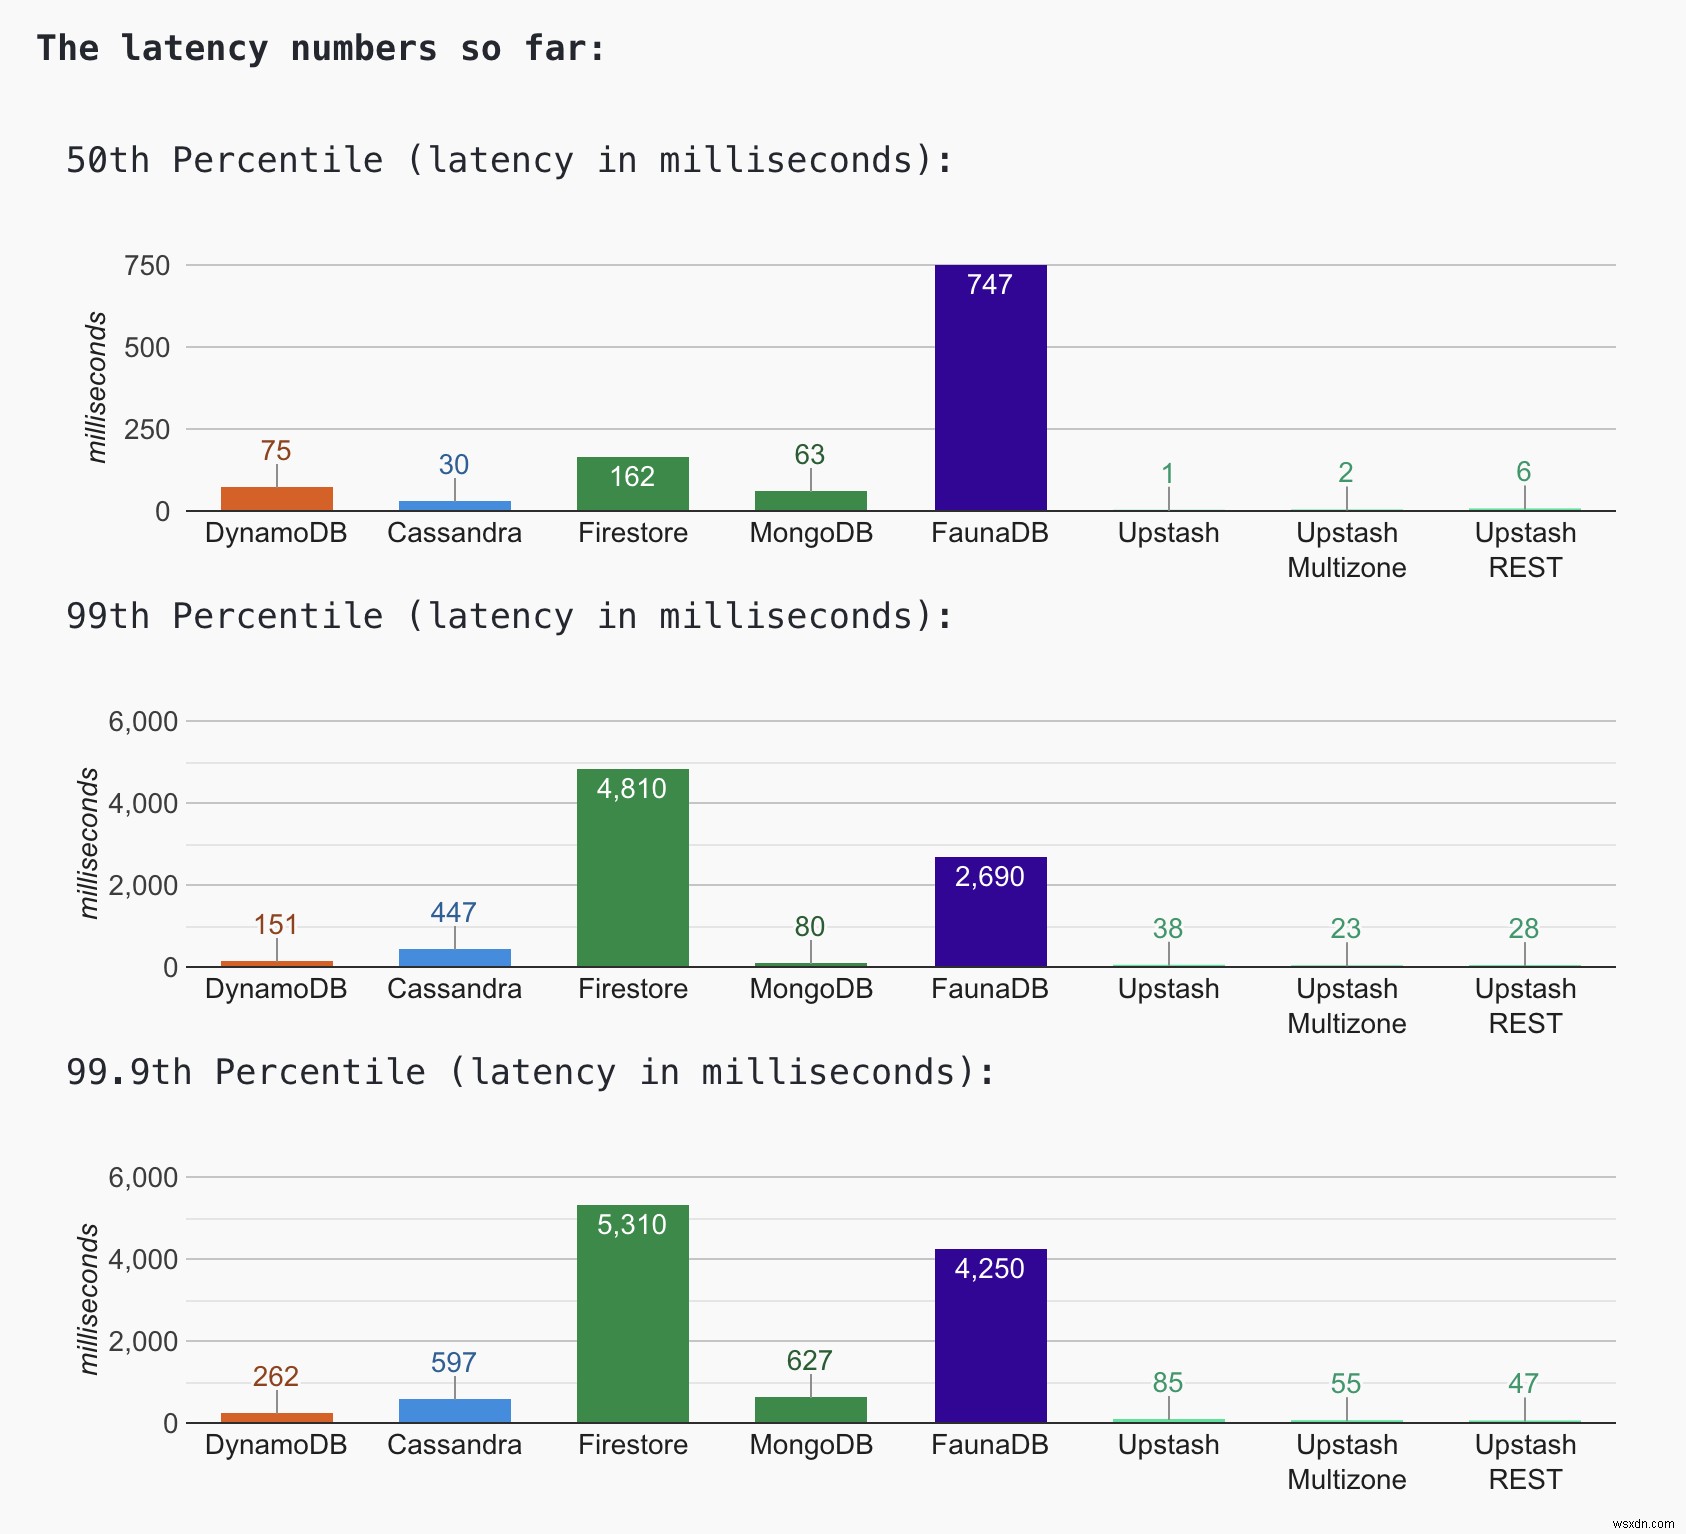
আজ (আগস্ট ২৫) পর্যন্ত লেটেন্সি নম্বরগুলো নিচে দেওয়া হলো:
প্রতিটি ডেটাবেসের কাস্টম কনফিগারেশন
DynamoDB
- রিজন: US-West-1
- রিড/রাইট ক্যাপাসিটি: ৫০ (ডিফল্ট ৫)
- ইন্ডেক্স: GSI với পার্টিশন কি
section(String) এবং সর্ট কিview_count(Number) - নোট: গ্লোবাল টেবিলস সক্ষম নয় কারণ ক্লায়েন্ট ইতিমধ্যেই একই রিজনে (US-West-1)
- কোড দেখুন
MongoDB (Atlas)
- রিজন: AWS N. Virginia (us-east-1)
- ক্লাস্টার টিয়ার: M5 (General)
- ইন্ডেক্স:
sectionএবংview_count上的 কম্পাউন্ড ইন্ডেক্স - নোট: MongoDB সার্ভারলেস অফারিং ট্রাই করতে চেয়েছিলাম কিন্তু Node.js ড্রাইভার নেই। তবে এটি সমস্যা নয় কারণ লেটেন্সি ক্যালকুলেশনের বাইরে ডিবি কানেকশন রেখেছি।
- কোড দেখুন
Firestore
- রিজন: GCP US-Central
- মোড: Datastore
- ইন্ডেক্স:
section(ascending) এবংview_count(descending)上的 কম্পোজিট ইন্ডেক্স - কোড দেখুন
Cassandra (DataStax Astra)
- রিজন: AWS US-East-1
- প্ল্যান: Pay as you go
- ইন্ডেক্স: PRIMARY KEY (section, view_count, id)
- API: REST API
- কোড দেখুন
FaunaDB
- প্ল্যান: Individual ($25/মাস)
- ইন্ডেক্স: term=section, value=view_count
- API: FQL
- কোড দেখুন
Redis (Upstash)
- রিজন: AWS US-West-1
- প্ল্যান: Pay as you go
- ইন্ডেক্স: SortedSet ব্যবহার করা হয়েছে
- নোট: সিঙ্গল এবং মাল্টি-জোন ডেটাবেস আলাদাভাবে টেস্ট করা হয়েছে
- কোড দেখুন
বিশেষ টিপ্পণী
- FaunaDB: ডিফল্টভাবে স্ট্রং কনসিস্টেন্সি গ্যারান্টি এবং গ্লোবাল রেপ্লিকেশন দেয়। আপনি রিজন বেছে নিতে পারবেন না। এগুলোই এর কম পারফরম্যান্সের কারণ হতে পারে।
- Firestore: অন্যদের মতো পারফরম্যান্স কিন্তু বেশি ভেরিয়েন্স। এর কারণ হতে পারে কোল্ড কানেকশনের ওভারহেড। কানেকশন alive রাখার উপায় খুঁজে পেলাম না। আপনার আগ্রহ থাকলে জানাতে পারেন।
- Cassandra: প্রাইমারি কি ফিল্ড আপডেট করতে দেয় না। সেকেন্ডারি ইন্ডেক্স অনেক আপডেট হলে রিকমেন্ড করা হয় না। তাই
view_countআপডেট করতে পারিনি যা পারফরম্যান্স ধনাত্মকভাবে প্রভাবিত করতে পারত। - Upstash: সিঙ্গল জোন কিছুটা দ্রুত見える, কিন্তু সিঙ্গল ও মাল্টি-জোন সেটআপের মাঝে বড় পারফরম্যান্স পার্থক্য নেই। উচ্চ পারসেন্টাইলে REST API-এর পারফরম্যান্স নেটিভ API-এর খুব কাছাকাছি।
এটি একটি চলমান প্রচেষ্টা, তাই আমরা কোড রিফ্যাক্টর করে বেঞ্চмар্কের গুণমান উন্নত করতে থাকব। যখন কোনো প্রোডাক্টের কোড রিফ্যাক্টর করব, তার হিস্টোগ্রাম রিসেট করব। কোড চেক করে আমাদের জানান যদি উন্নতির সুযোগ থাকে। টুইটার এবং ডিস্কর্ড-এ যোগাযোগ করুন।
