

TensorFlow হল Google প্রদত্ত একটি মেশিন লার্নিং ফ্রেমওয়ার্ক। এটি একটি ওপেন-সোর্স ফ্রেমওয়ার্ক যা পাইথনের সাথে সংযোগে অ্যালগরিদম, ডিপ লার্নিং অ্যাপ্লিকেশন ইত্যাদি বাস্তবায়নে ব্যবহৃত হয়। এটি গবেষণা এবং প্রোডাকশন উদ্দেশ্যে ব্যবহৃত হয়। এতে জটিল গাণিতিক অপারেশন দ্রুত সম্পাদনের জন্য অপ্টিমাইজেশন কৌশল রয়েছে। এটি NumPy এবং মাল্টি-ডাইমেনশনাল অ্যারে ব্যবহার করার কারণে। এই মাল্টি-ডাইমেনশনাল অ্যারেগুলোকে 'টেনসর'ও বলা হয়। ফ্রেমওয়ার্কটি ডিপ নিউরাল নেটওয়ার্কের সাথে কাজ করা সাপোর্ট করে। এটি অত্যন্ত স্কেলেবল এবং অনেক জনপ্রিয় ডেটাসেট নিয়ে আসে।
টেনসর TensorFlow-এ ব্যবহৃত একটি ডেটা স্ট্রাকচার। এটি একটি ফ্লো ডায়াগ্রামে এজ সংযোগ করতে সাহায্য করে। এই ফ্লো ডায়াগ্রামকে 'Data flow graph' বলা হয়। টেনসরসমূহ আসলে মাল্টি-ডাইমেনশনাল অ্যারে বা একটি লিস্ট।
রিগ্রেশন সমস্যার উদ্দেশ্য হল একটি কন্টিনিউয়াস বা ডিসক্রিট ভেরিয়েবলের আউটপুট পূর্বাভাস করা, যেমন দাম, সম্ভাবনা, বৃষ্টি হবে কিনা ইত্যাদি।
আমরা যে ডেটাসেট ব্যবহার করছি তা 'Auto MPG' ডেটাসেট। এতে ১৯৭০ এবং ১৯৮০ দশকের অটোমোবাইলদের ফুয়েল এফিশিয়েন্সি রয়েছে। এতে ওজন, হর্সপাওয়ার, ডিসপ্লেসমেন্ট ইত্যাদি অ্যাট্রিবিউট রয়েছে। এর সাহায্যে আমাদের নির্দিষ্ট যানবাহনların ফুয়েল এফিশিয়েন্সি পূর্বাভাস করতে হবে।
নিচের কোড চালাতে আমরা Google Colaboratory ব্যবহার করছি। Google Colab বা Colaboratory ব্রাউজারের মাধ্যমে পাইথন কোড চালাতে সাহায্য করে এবং এটি শূন্য কনফিগারেশনের সাথে ফ্রি GPU অ্যাক্সেস প্রদান করে (Graphical Processing Units)। Colaboratory Jupyter Notebook-এর উপরে তৈরি।
নিচে কোড স্নিপেট দেওয়া হলো যেখানে দেখানো হয়েছে TensorFlow ব্যবহার করে Auto MPG ডেটাসেটে ফুয়েল এফিশিয়েন্সি পূর্বাভাসের জন্য ডেটা কিভাবে বিভক্ত ও পরিদর্শন করা যায়:
উদাহরণ
print("Splitting the training and testing dataset")
train_dataset = dataset.sample(frac=0.7, random_state=0)
test_dataset = dataset.drop(train_dataset.index)
print("Plotting the training data as a visualization")
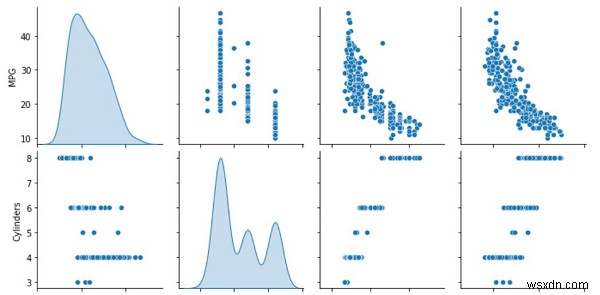
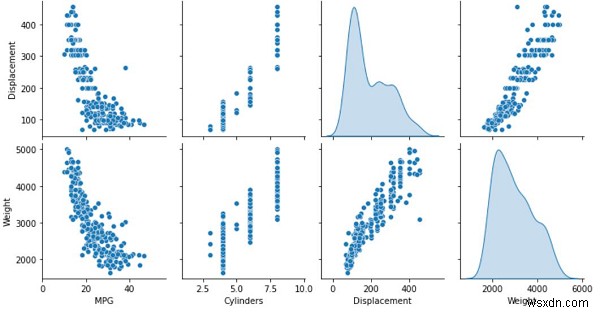
sns.pairplot(train_dataset[['MPG', 'Cylinders', 'Displacement', 'Weight']], diag_kind='kde')
print("Understanding the statistics associated with the data")
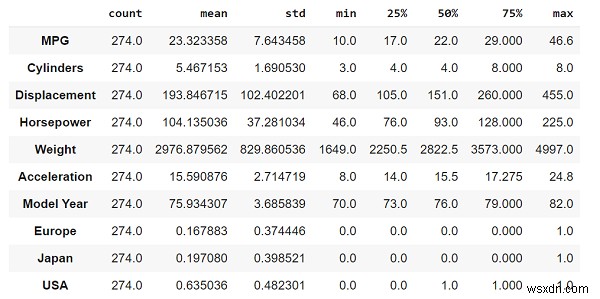
train_dataset.describe().transpose()
কোড ক্রেডিট - https://www.tensorflow.org/tutorials/keras/regression
আউটপুট
Splitting the training and testing dataset
Plotting the training data as a visualization
Understanding the statistics associated with the data
ব্যাখ্যা
ডেটা ক্লিন হলে, ডেটা ট্রেনিং এবং টেস্ট ডেটাসেটে বিভক্ত করা হয়।
৭০ শতাংশ ডেটা ট্রেনিং এবং বাকি ৩০ শতাংশ টেস্টিং-এর জন্য ব্যবহার করা হয়।
এই ট্রেনিং ডেটা Seaborn প্যাকেজ ব্যবহার করে কনসোলে ভিজ্যুয়ালাইজ করা হয়।
ডেটার সাংখ্যিকीय তথ্য, যেমন কাউন্ট, মিন, মেডিয়ান ইত্যাদি 'describe' ফাংশন ব্যবহার করে প্রদর্শিত হয়।
