

क्या आपने कभी अपने ऐप में CSV फ़ाइल से ढेर सारा डेटा आयात करना चाहा है? या शायद आपको कुछ ग्राहक समीक्षाओं में खराब एन्कोडेड कैरेक्टर ठीक करने हैं। या आपने Redis में डेटा स्टोर करने का तरीका बदल दिया है, और पुराने फॉर्मेट से नए फॉर्मेट में सब कुछ ले जाना है।
Avvo में, हम इन्हें "अड-हक टास्क" कहते थे। यानी, आपको शायद उन्हें केवल एक बार चलाने की आवश्यकता है। तो रेल्स में अड-हक टास्क को संभालने का सबसे अच्छा तरीका क्या है?
एक डेटाबेस माइग्रेशन लिखें
यदि आपको अपने डेटाबेस में डेटा की संरचना बदलने की आवश्यकता है, तो माइग्रेशन अच्छा काम करता है। यह ट्रैक करता है कि टास्क चलाया गया था या नहीं, यह अन्य एनवायरनमेंट में बदलाव को आगे बढ़ाता है—यही वह काम है जिसके लिए माइग्रेशन बने थे। यह शायद वह भी है जिसके लिए आप पहले से ही उनका उपयोग कर रहे हैं।
अगर आप उसी समय डेटा बदल रहे हैं, तो माइग्रेशन काम कर सकता है। लेकिन कुछ बातों का ध्यान रखना होगा।
अपने माइग्रेशन में Permissions.create(...) जैसा कुछ कॉल करना आपको मुसीबत में डाल सकता है। यदि मॉडल बदल गया है, तो आपका माइग्रेशन टूट सकता है, क्योंकि माइग्रेशन चलने पर आपका मॉडल उपलब्ध नहीं हो सकता। या आपके माइग्रेशन लिखने और उसके चलने के बीच मॉडल बदल गया हो। इससे बचने के तरीके हैं, लेकिन वे त्रुटि-प्रवण हैं और अजीब तरीकों से विफल हो सकते हैं।
यदि आपका टास्क ActiveRecord से संबंधित नहीं है, तो माइग्रेशन कम उपयोगी हैं।
ये डील-ब्रेकर नहीं हैं। लेकिन मैं माइग्रेशन में ज्यादा डेटा आयात या बदलाव नहीं करता। बेहतर विकल्प मौजूद हैं।
एक रेक टास्क लिखें
आपके पास एक टास्क है। आप शायद इसे केवल एक बार चलाना चाहते हैं। और आप इसे अपनी मशीन पर टेस्ट करना और प्रोडक्शन में चलाना चाहते हैं।
रेक टास्क इसके लिए वास्तव में अच्छा काम करते हैं। रेल्स आपके लिए रेक टास्क जनरेट भी कर सकता है:
$ be rails g task locations import create lib/tasks/locations.rakeयह आपके कोड रखने के लिए एक फ़ाइल बनाता है:
namespace :locations do desc "TODO" task import: :environment do end endउस task ब्लॉक के अंदर, आप अपने सभी मॉडल और अपने रेल्स ऐप के बाकी कोड का उपयोग कर सकते हैं। डेटा आयात करना और बदलना आसान है, क्योंकि आप अपना कोड ठीक वैसे ही लिख सकते हैं जैसे आप रेल्स कंसोल पर बैठे हों।
एक बार जब आप अपना टास्क लिख लेते हैं, तो आप इसे rake locations:import के साथ चला सकते हैं। यदि आप Heroku का उपयोग कर रहे हैं, तो आप इसे heroku run rake locations:import के साथ चला सकते हैं। यदि आप Capistrano का उपयोग कर रहे हैं, तो आप capistrano-rake जेम का उपयोग करके अपना टास्क चला सकते हैं। हालांकि, आपके पास एक और भी बेहतर विकल्प हो सकता है।
sidekiq-scheduler का उपयोग करके एक शेड्यूल्ड जॉब लिखें
यदि आपका ऐप काफी बड़ा है, तो आप शायद पहले से ही Sidekiq, Resque, या ऐसा ही कुछ उपयोग कर रहे हैं।
इनमें से अधिकांश बैकग्राउंड जॉब प्रोसेसर जॉब को बाद में चलाने के लिए शेड्यूल कर सकते हैं। Sidekiq में, उदाहरण के लिए, sidekiq-scheduler जेम है। और sidekiq-scheduler के साथ, आप एक ट्रिक कर सकते हैं।
क्या होगा यदि आपके पास एक जॉब हो जो स्वचालित रूप से खुद को कभी शेड्यूल न करे, लेकिन आपको जब चाहे तब इसे मैन्युअली शेड्यूल करने दे? यह उन "वन-ऑफ" जॉब के लिए बहुत अच्छा काम करेगा जिन्हें आप बाद में फिर से चलाना चाहें, या जिन्हें आप UI का उपयोग करके चलाना पसंद करें।
sidekiq-scheduler में, आप जॉब को दूर भविष्य में शेड्यूल कर सकते हैं, और जॉब को डिसेबल सेट कर सकते हैं:
:schedule: location_importer: class: LocationImporterWorker at: '3001/01/01' enabled: falseफिर, जब आप sidekiq-web पर जाएंगे, तो आपको जॉब को मैन्युअली एन्क्यू करने के लिए एक बटन दिखाई देगा:
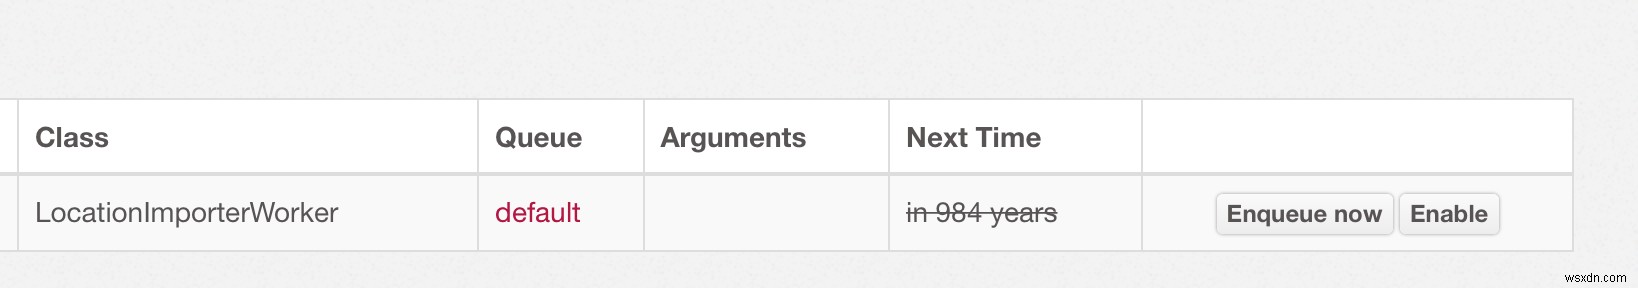
इसके साथ, आप अपने जॉब को जब भी तैयार हों, डेवलपमेंट और प्रोडक्शन दोनों में चला सकते हैं। और यदि आपको इसे फिर से चलाने की आवश्यकता है, तो यह UI में वहीं मौजूद है।
यदि आपका जॉब खतरनाक है तो यह सबसे अच्छा विकल्प नहीं है। उस बटन पर गलती से क्लिक करना बहुत आसान है। और यदि जॉब को पूरा होने में समय लगता है तो यह भी अच्छा नहीं है, क्योंकि Sidekiq तब सबसे अच्छा काम करता है जब जॉब जल्दी खत्म हों। आपका जॉब एक वर्कर पर कब्जा कर लेगा, और आप अपने जॉब के खत्म होने तक सुरक्षित रूप से Sidekiq को रीस्टार्ट नहीं कर पाएंगे। लेकिन अगर आपका जॉब तेज है, और एक से अधिक बार सुरक्षित रूप से चल सकता है, तो यह अच्छा काम करता है। यदि यह एक क्लीनअप टास्क है, तो आप तय कर सकते हैं कि आप इसे नियमित रूप से चलाना चाहते हैं।
यदि आप केवल शेड्यूलिंग और ट्रिगरिंग पर ध्यान केंद्रित करना चाहते हैं, या अपने वन-टाइम स्क्रिप्ट में पैरामीटर सेट करने के लिए अधिक लचीलापन चाहते हैं, तो एक पाठक, दिमित्री ने मुझे sidekiq-enqueuer की ओर इशारा किया। sidekiq-enqueuer के साथ, आप Sidekiq वेब इंटरफेस के माध्यम से जॉब शेड्यूल कर सकते हैं और पैरामीटर सेट कर सकते हैं।
प्रोडक्शन में SSH करें और रेल्स कंसोल में कोड पेस्ट करें
सिर्फ मजाक कर रहा हूँ।
आपको कौन सा चुनना चाहिए?
मैंने वन-ऑफ टास्क चलाने के इन सभी तरीकों का उपयोग किया है। लेकिन मैं आमतौर पर पहले रेक टास्क के लिए जाता हूँ। यह काम करता है, गलती से चलाना मुश्किल है, और जब आपका काम हो जाए तो इसे हटाना आसान है। मैं हर बार रेक टास्क नहीं चुनता, हालांकि।
मैं माइग्रेशन चुन सकता हूँ अगर:
- जॉब डेटाबेस स्कीमा परिवर्तन के हिस्से के रूप में SQL का उपयोग करके डेटा ठीक करता है।
- जॉब बहुत सरल डेटा कार्य है, जैसे किसी कॉलम में डेटा बदलना या कुछ रिकॉर्ड जोड़ना।
- मैं आसानी से ट्रैक करना चाहता हूँ कि जॉब चलाया गया है या नहीं, और इसे दोबारा नहीं चलाना चाहता।
मैं Sidekiq जॉब चुन सकता हूँ अगर:
- मुझे लगता है कि मैं बाद में जॉब को फिर से चलाना चाहूंगा।
- मेरे अलावा किसी और को इसे चलाना है। उन्हें बस एक बटन पर क्लिक करना होगा।
- यह एक छोटा डेटा आयात या डेटा क्लीनअप जॉब है। मुझे शायद इसे नियमित रूप से चलाना पड़े, भले ही मुझे शुरू में इसकी उम्मीद न हो।
आपका क्या ख्याल है? क्या आपके पास कोई अन्य विकल्प है, या आप अलग चुनाव करते हैं? कमेंट करके मुझे बताएं!
