

পার্সিং হলো অনেক স্ট্রিং থেকে অর্থ বের করে সেগুলোকে বোঝার যোগ্য ফরম্যাটে রূপান্তর করার কAws। আপনি রেগুলার এক্সপ্রেশন ব্যবহার করতে পারেন, কিন্তু সেটি সবসময় উপযুক্ত নয়।
উদাহরণস্বরূপ, HTML পার্স করতে রেগুলার এক্সপ্রেশন ব্যবহার করা ভালো ধারণা নয় — এটি সার্বজনীন জ্ঞান।
রুবিতে Nokogiri আছে যা এই কাজটি করে দিতে পারে, কিন্তু নিজে পার্সার বানাতে শিখলে অনেক কিছু জানতে পারবেন। চলুন শুরু করি!
রুবিতে পার্সিং
আমাদের পার্সারের কোর হলো StringScanner ক্লাস।
এই ক্লাস একটি স্ট্রিংর কপি এবং একটি পজিশন পয়েন্টার ধরে রাখে। পয়েন্টারটি আমাদের স্ট্রিং ট্রাভার্স করতে দেয় নির্দিষ্ট টোকেন খুঁজে বের করার জন্য।
আমরা যে মেথডগুলো ব্যবহার করব:
.peek.scan_until.getch
এছাড়াও .scan (until ছাড়া) একটি উপকারী মেথড।
নোট:
যদি StringScanner উপলব্ধ না থাকে, তবে require 'strscan' যোগ করে দেখুন।
আমি দুটি টেস্ট লিখেছি ডকুমেন্টেশন হিসেবে, যাতে এই ক্লাস কীভাবে কাজ করে তা বুঝতে পারি:
describe StringScanner do
  let (:buff) { StringScanner.new "testing" }
  it "can peek one step ahead" do
    expect(buff.peek 1).to eq "t"
  end
  it "can read one char and return it" do
    expect(buff.getch).to eq "t"
    expect(buff.getch).to eq "e"
  end
end
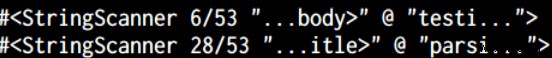
এই ক্লাসের একটি গুরুত্বপূর্ণ বিষয়: কিছু মেথড পজিশন পয়েন্টার বাড়িয়ে দেয় (getch, scan), অন্যগুলো না (peek)। যেকোনো সময় আপনি আপনার স্ক্যানার ইন্সপেক্ট করতে পারেন (.inspect বা p ব্যবহার করে) দেখতে এটি কোথায় আছে।
পার্সার ক্লাস
পার্সার ক্লাস হলো যেখানে মূল কাজটি হয়। আমরা এটি পার্স করতে চাই এমন টেক্সট স্নিপেট দিয়ে ইনিশিয়ালাইজ করব, এটি সেটার জন্য একটি StringScanner তৈরি করবে এবং parse মেথড কল করবে:
def initialize(str)
  @buffer = StringScanner.new(str)
  @tags = []
  parse
end
টেস্টে আমরা এভাব ডিফাইন করি:
let(:parser) { Parser.new "<body>testing</body> <title>parsing with ruby</title>" }
এই ক্লাস কীভাবে কাজ করে তা একটু পরেই দেখব, কিন্তু আগে প্রোগ্রামের শেষ টুকরো দেখে নেই।
Tag ক্লাস
এই ক্লাস খুবই সহজ, এটি মূলত পার্সিং ফলাফলের জন্য একটি কন্টেইনার ও ডেটা ক্লাস হিসেবে কাজ করে।
class Tag
  attr_reader :name
  attr_accessor :content
  def initialize(name)
    @name = name
  end
end
চলুন পার্স করি!
কোনো কিছু পার্স করতে হলে ইনপুট টেক্সটে প্যাটার্ন খুঁজে বের করতে হয়। উদাহরণস্বরূপ, আমরা জানি HTML কোডের ফরম নিম্নরূপ:
<tag>contents</tag>
এখানে স্পষ্টভাবে দুটি কম্পোনেন্ট চিহ্নিত করা যায় — ট্যাগের নাম এবং ট্যাগের ভেতরের টেক্সট। যদি আমরা BNF নোটেশন ব্যবহার করে একটি ফরম্যাল গ্রামার ডিফাইন করি, তবে সেটি এমন দেখাবে:
tag = <opening_tag> <contents> <closing_tag>
opening_tag = "<" <tag_name> ">"
closing_tag = "</" <tag_name> ">"
আমরা StringScanner-এর peek ব্যবহার করে দেখব ইনপুট বাফারের পরবর্তী সিম্বল কি ওপেনিং ট্যাগ। যদি হয়, তবে আমাদের Parser ক্লাসের find_tag এবং find_content মেথড কল করব:
def parse_element
  if @buffer.peek(1) == '<'
    @tags << find_tag
    last_tag.content = find_content
  end
end
find_tag মেথডটি:
- ওপেনিং ট্যাগ ক্যারেক্টার 'খাবে' (consume)
- বন্ধ সিম্বল ('>') পাওয়া পর্যন্ত স্ক্যান করবে
- ট্যাগের নাম দিয়ে একটি নতুন Tag অবজেক্ট তৈরি ও রিটার্ন করবে
কোডটি নিচে, লক্ষ্য করুন কীভাবে আমরা chop করছি শেষ ক্যারেক্টারটি। কারণ scan_until ফলাফলে '>' অন্তর্ভুক্ত করে, যা আমরা চাই না।
def find_tag
  @buffer.getch
  tag = @buffer.scan_until />/
  Tag.new(tag.chop)
end
পরবর্তী ধাপ হলো ট্যাগের ভেতরের কন্টেন্ট খুঁজে বের করা, এটি কঠিন না কারণ scan_until পজিশন পয়েন্টারকে সঠিক জায়গায় নিয়ে যায়। আমরা আবার scan_until ব্যবহার করব ক্লোজিং ট্যাগ খুঁজে বের করতে এবং ট্যাগ কন্টেন্ট রিটার্ন করতে।
def find_content
  tag = last_tag.name
  content = @buffer.scan_until /<\/#{tag}>/
  content.sub("</#{tag}>", "")
end
এখন:
আমাদের শুধু parse_element কে একটি লুপে কল করতে হবে যতক্ষণ না ইনপুট বাফারে আর কোনো ট্যাগ পাওয়া যায়।
def parse
  until @buffer.eos?
    skip_spaces
    parse_element
  end
end
সম্পূর্ণ কোডটি এখানে পাবেন: https://github.com/matugm/simple-parser। নেস্টেড ট্যাগ হ্যান্ডল করার এক্সটেনডেড ভার্সনের জন্য 'nested_tags' ব্রাঞ্চটি দেখুন।
উপসংহার
পার্সার লিখা একটি আকর্ষণীয় টপিক এবং এটি অনেক সময় জটিল হতে পারে।
যদি আপনি স্ক্র্যাচ থেকে নিজস্ব পার্সার বানাতে না চান, তবে所謂 'parser generators' ব্যবহার করতে পারেন। রুবিতে Treetop এবং Parslet আছে।
