

এই পোস্টে, আমরা নিউরাল নেটওয়ার্কের বেসিক্স শিখব এবং কীভাবে রুবি ব্যবহার করে সেগুলো ইমপ্লিমেন্ট করতে পারি! আপনি যদি আর্টিফিশিয়াল ইন্টেলিজেন্স এবং ডিপ লার্নিং-এ আগ্রহী হন কিন্তু কীভাবে শুরু করবেন সেটা না জানেন, তবে এই পোস্ট আপনার জন্য! আমরা একটি সহজ উদাহরণ দিয়ে মূল কনসেপ্টগুলো হাইলাইট করব। রুবি ব্যবহার করে মাল্টি-লেয়ার নিউরাল নেটওয়ার্ক লিখা খুব সম্ভব নয়, কিন্তু সিমপ্লিসিটি এবং রিডেবিলিটির জন্য, এটি বুঝতে চমৎকার একটি উপায়। প্রথমে, আসুন একটু পেছনে হটে দেখি আমরা কীভাবে এখানে পৌঁছেছি।
 ছবি: Ex Machina সিনেমা থেকে। ফটো ক্রেডিট
Ex Machina ২০১৪ সালে রিলিজ হয়েছিল। গুগলে টাইটেলটি সার্চ করলে এটি "Drama/Fantasy" জেনরে ক্লাসিফাই করে। এবং যখন আমি প্রথম সিনেমাটি দেখলাম, তখন এটাতে সাইন্স ফিকশন লাগলো।
কিন্তু, অনেক বেশি দিনের জন্য?
আপনি যদি রে কুর্সওয়ীলকে জিজ্ঞেস করেন, গুগলে কাজ করা một বিখ্যাত ভবিষ্যৎবক্তা, তিনি বলেন ২০২৯ কে হলো সেই বছর যখন আর্টিফিশিয়াল ইন্টেলিজেন্স একটি বৈধ টারিং টেস্ট পাস করবে (যা একটি এক্সপেরিমেন্ট যেটি দেখে কোনো মানুষ মেশিন/কম্পিউটার এবং অন্য একজন মানুষের মধ্যে পার্থক্য করতে পারে কিনা)। তিনি আরও প্রিডিক্ট করেন সিঙ্গুলারিটি (যখন কম্পিউটার মানব বুদ্ধিমত্তা অতিক্রম করবে) ২০৪৫ সালে উদ্ভূত হবে।
কুর্সওয়ীল এত আত্মবিশ্বাসী কেন?
ডিপ লার্নিং-এর উদ্ভব
সহজ ভাষায়, ডিপ লার্নিং হলো মেশিন লার্নিং-এর একটি সাবসেট যা নিউরাল নেটওয়ার্ক ব্যবহার করে বড় ডেটা থেকে ইনসাইট বের করে। ডিপ লার্নিং-এর রিয়েল-ওয়ার্ল্ড অ্যাপ্লিকেশনগুলো شامل:
- সেলফ-ড্রাইভিং কার
- ক্যান্সার ডিটেকশন
- ভার্চুয়াল অ্যাসিস্ট্যান্ট, যেমন Siri এবং Alexa
- চরম আবহাওয়া ইভেন্ট প্রিডিক্ট করা, যেমন ভূমিকম্প
আপনি, "নিউরাল নেটওয়ার্ক" কী?
নিউরাল নেটওয়ার্কের নাম এসেছে নিউরন থেকে, যেগুলো মস্তিষ্কের সেল যা ইলেকট্রিক্যাল এবং কেমিক্যাল সিগন্যাল দিয়ে ইনফোর্মেশন প্রসেস এবং ট্রান্সমিট করে। মজার তথ্য: মানব মস্তিষ্ক ৮০+ বিলিয়ন নিউরন দিয়ে তৈরি!
কম্পিউটিং-এ, একটি নিউরাল নেটওয়ার্ক এইরকম দেখে:
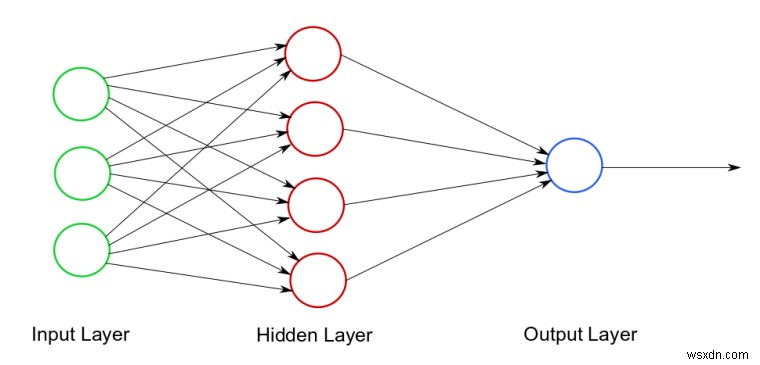 উদাহরণ নিউরাল নেটওয়ার্ক ডায়াগ্রাম। ফটো ক্রেডিট
আপনি দেখতে পাচ্ছেন, তিনটি পার্ট আছে: ১) ইনপুট লেয়ার -- প্রাথমিক ডেটা ২) হিডেন লেয়ার(র) -- একটি নিউরাল নেটওয়ার্কে ১ (বা অধিক) হিডেন লেয়ার থাকতে পারে। সেখানে সকল কম্পিউটেশন হয়! ৩) আউটপুট লেয়ার -- চূড়ান্ত ফলাফল/প্রিডিকশন।
একটি দ্রুত ইতিহাস পাঠ
নিউরাল নেটওয়ার্ক নতুন নয়। আসলে, প্রথম ট্রেনেবল নিউরাল নেটওয়ার্ক (পারসেপট্রন) ১৯৫০-এর দশকে কর্নেল ইউনিভার্সিটিতে ডেভেলপ হয়েছিল। তবে নিউরাল নেটওয়ার্কের প্রয়োগ্যতা চारोंओর অনেক পেসিমিজম ছিল, মূলত কারণ আসল মডেল শুধু একটি হিডেন লেয়ার দিয়ে बना ছিল। ১৯৬৯ সালে প্রকাশিত একটি বই দেখিয়েছিল পারসেপট্রন ব্যবহার করে অন্য অত্যন্ত সহজ কম্পিউটেশনও অপর্যাপ্ত।
নিউরাল নেটওয়ার্কের পুনর্জাগরণের কারণ কമ്പিউটার গেম, যেগুলো এখন অত্যন্ত হাই-পাওয়ার্ড গ্রাফিক্স প্রসেসিং ইউনিট (GPU) চায়, যাদের আর্কিটেকচার নিউরাল নেটের সাথে খুব মিলে। পার্থক্য হলো হিডেন লেয়ারের সংখ্যা। একের বদলে, আজকাল ট্রেন হওয়া নিউরাল নেটওয়ার্ক ১০, ১৫, অথবা ৫০+ লেয়ার ব্যবহার করছে!
উদাহরণের সময়!
এটি কীভাবে কাজ করে বুঝতে, আসুন একটি উদাহরণ দেখি। আপনাকে ruby-fann জেম ইনস্টল করতে হবে। টার্মিনাল খুলুন এবং আপনার ওয়ার্কিং ডিরেক্টরিতে যান। তারপর রান করুন:
gem install ruby-fann
একটি নতুন রুবি ফাইল তৈরি করুন (আমি আমার ফাইলের নাম দিয়েছিলাম neural-net.rb)।
পরবর্তী, আমরা Kaggle-র "Student Alcohol Consumption" ডেটাসেট ব্যবহার করব। আপনি এখান থেকে ডাউনলোড করতে পারেন। student-mat.csv ফাইলটি Google Sheets-এ খুলুন (বা আপনার পছন্দের এডিটরে)। নিচের কলামগুলো ছাড়া সব ডিলিট করুন: - Dalc (বুধবার থেকে শুক্রবারের অ্যালকোহল কনসাম্পশন, ১ ভেরি লো এবং ৫ ভেরি হাই) - Walc (উইকএন্ড অ্যালকোহল কনসাম্পশন, ১ ভেরি লো এবং ৫ ভেরি হাই) - G3 (ফাইনাল গ্রেড ০ থেকে ২০ পর্যন্ত)
আমাদের ফাইনাল গ্রেড কলামকে বাইনারি করতে হবে -- یا ০ অথবা ১ -- যাতে ruby-fann জেম কাজ করে। এই উদাহরণে, আমরা ধরে নিচ্ছি ১০ বা তার কম হলো "০" এবং ১০ এর বেশি হলো "১"। আপনি যেই প্রোগ্রাম ব্যবহার করছেন, সেটি অনুযায়ী আপনি সেলে একটি ফর্মুলা লিখতে পারেন যা অটোমেটিক ভ্যালু ১ বা ০-এ পরিবর্তন করবে। Google Sheets-এ এটি দেখতে এইরকম:
=IF(C3 >= 10, 1, 0)
এই ডেটা .CSV ফাইল হিসেবে সেভ করুন (আমি আমার ফাইলের নাম দিয়েছিলাম students.csv) আপনার রুবি ফাইলের সেম ডিরেক্টরিতে।
আমাদের নিউরাল নেটওয়ার্কের নিচের লেয়ারগুলো থাকবে: - ইনপুট লেয়ার: ২ নোড (বুধ-শুক্র অ্যালকোহল কনসাম্পশন এবং উইকএন্ড অ্যালকোহল কনসাম্পশন) - হিডেন লেয়ার: ৬ হিডেন নোড (এটি কিছুটা আربیট্রেরি শুরুতে; আপনি পরে টেস্ট করার время মডিফাই করতে পারেন) - আউটপুট লেয়ার: ১ নোড (হয় ০ অথবা ১)
প্রথমে, আমাদের ruby-fann জেম এবং বিল্ট-ইন csv লাইব্রেরি রিকোয়ার করতে হবে। আপনার রুবি প্রোগ্রামের প্রথম লাইনে এটি যোগ করুন:
require 'ruby-fann' require 'csv'
পরবর্তী, আমাদের CSV ফাইল থেকে ডেটা লোড করে অ্যারেতে রাখতে হবে।
# দুটি খালি অ্যারে তৈরি করুন। একটা আমাদের ইনডিপেন্ডেন্ট ভেরিয়েবল (x_data) ধারণ করবে, আরেকটা ডিপেন্ডেন্ট ভেরিয়েবল (y_data)। x_data = [] y_data = [] # আমাদের CSV ডেটা traversé করুন এবং উপযুক্ত অ্যারেতে এলিমেন্ট যোগ করুন। # নোট: যদি আমরা .to_f এবং .to_i না দিই, তবে আমাদের অ্যারেতে স্ট্রিং থাকবে, এবং ruby-fann লাইব্রেরি খুশি হবে না। CSV.foreach("students.csv", headers: false) do |row| x_data.push([row[0].to_f, row[1].to_f]) y_data.push(row[2].to_i) end পরবর্তী, আমাদের ডেটাকে ট্রেনিং এবং টেস্টিং ডেটাতে ভাগ করতে হবে। ৮০/২০ স্প্লিট খুব সাধারণ, যেখানে ২০% ডেটা টেস্টিংয়ের জন্য এবং ৮০% ট্রেনিংয়ের জন্য। "ট্রেনিং" এখানে মানে মডেল এই ডেটা থেকে শিখবে, এবং তারপর আমরা আমাদের "টেস্টিং" ডেটা ব্যবহার করে দেখব মডেল কতটুকু ভালো প্রিডিক্ট করে।
# ডেটাকে ট্রেনিং সেট এবং টেস্ট সেটে ভাগ করুন। testing_percentage = 20.0 # টোটাল এলিমেন্টের সংখ্যা গুন করুন টেস্ট পারসেন্টেজ দিয়ে। testing_size = x_data.size * (testing_percentage/100.to_f) # শুরু থেকে শুরু করে testing_size - 1 পর্যন্ত (যেহেতু অ্যারে ০-ইনডেক্সড)। x_test_data = x_data[0 .. (testing_size-1)] y_test_data = y_data[0 .. (testing_size-1)] # যেখানে ছেড়ে দিয়েছিলাম সেখান থেকে ডেটাসেটের শেষ পর্যন্ত। x_train_data = x_data[testing_size .. x_data.size] y_train_data = y_data[testing_size .. y_data.size] কুল! আমাদের ডেটা রেডি। এখন আসছে ম্যাজিক!
# ট্রেনিং ডেটা মডেল সেট আপ করুন। train = RubyFann::TrainData.new(:inputs=> x_train_data, :desired_outputs=>y_train_data) আমরা RubyFann::TrainData অবজেক্ট ব্যবহার করছি, এবং পাস করছি আমাদের x_train_data, যেটি আমাদের বুধ-শুক্র এবং উইকএন্ড অ্যালকোহল কনসাম্পশন, এবং y_train_data, যেটি ০ বা ১ ফাইনাল কোর্স গ্রেড বেসড।
এখন, আমাদের আসল নিউরাল নেটওয়ার্ক মডেল সেট আপ করি আগে আলোচনা 했던 হিডেন নিউরনের সংখ্যা দিয়ে।
# মডেল সেট আপ করুন এবং ট্রেনিং ডেটা দিয়ে ট্রেন করুন। model = RubyFann::Standard.new( num_inputs: 2, hidden_neurons: [6], num_outputs: 1 ); ওকে, ট্রেন করার সময়!
model.train_on_data(train, 1000, 10, 0.01) এখানে, আমরা train ভেরিয়েবল পাস করছি যা আমরা আগে তৈরি করেছি। ১০০০ রিপ্রেজেন্ট করে max_epochs সংখ্যা, ১০ রিপ্রেজেন্ট করে রিপোর্টের মধ্যে এরর সংখ্যা, এবং ০.০১ আমাদের ডিজায়ারড মিন-স্কোয়ার্ড এরর। এক epoch হলো যখন সম্পূর্ণ ডেটাসেট নিউরাল নেটওয়ার্কের মধ্য থেকে পাস করে। মিন-স্কোয়ার্ড এরর হচ্ছে যা আমরা মিনিমাইজ করতে চাচ্ছি। আপনি এখানে আরও পড়তে পারেন এটি কী মানে।
পরবর্তী, আমরা জানতে চাই আমাদের মডেল কতটুকু ভালো কাজ করেছে আমাদের টেস্ট ডেটার জন্য মডেল যা প্রিডিক্ট করেছে সেটি একচুয়াল রেজাল্টের সাথে কমপেয়ার করে। আমরা এটা এই কোড দিয়ে করতে পারি:
predicted = [] # আমাদের x_test_data এর ওপর ইটারেট করুন, প্রতিটিয়ে মডেল রান করুন, এবং প্রিডিক্টেড অ্যারেতে যোগ করুন। x_test_data.each do |params| predicted.push( model.run(params).map{ |e| e.round } ) end # প্রিডিক্টেড রেজাল্ট একচুয়াল রেজাল্টের সাথে কমপেয়ার করুন। correct = predicted.collect.with_index { |e,i| (e == y_test_data[i]) ? 1 : 0 }.inject{ |sum,e| sum+e } # একুরেসি রেট প্রিন্ট করুন। puts "Accuracy: #{((correct.to_f / testing_size) * 100).round(2)}% - test set of size #{testing_percentage}%" আমাদের প্রোগ্রাম রান করি এবং দেখি কী হয়!
ruby neural-net.rb
আপনাকে Epochs-র জন্য অনেক আউটপুট দেখতে मिलবে, কিন্তু নিচে আপনি এমন কিছু দেখবেন:
Accuracy: 56.82% - test set of size 20.0%
ওফ, এটি খুব ভালো নয়! কিন্তু, আসুন আমাদের নিজের ডেটা পয়েন্ট বানাই এবং মডেল রান করি।
prediction = model.run( [1, 1] ) # আউটপুট রাউন্ড করুন প্রিডিকশন পাওয়ার জন্য। puts "Algorithm predicted class: #{prediction.map{ |e| e.round }}" prediction_two = model.run( [5, 4] ) # আউটপুট রাউন্ড করুন প্রিডিকশন পাওয়ার জন্য। puts "Algorithm predicted class: #{prediction_two.map{ |e| e.round }}" এখানে, আমাদের দুটি উদাহরণ। প্রথমে, আমরা ১ পাস করছি আমাদের বুধ-শুক্র এবং উইকএন্ড অ্যালকোহল কনসাম্পশনের জন্য। আমি যদি बेटিং করতাম, তবে আমি অনুমান করতাম এই ছাত্রের ফাইনাল গ্রেড ১০ এর উপরে হবে (অর্থাৎ ১)। দ্বিতীয় উদাহরণে হাই ভ্যালু (৫ এবং ৪) পাস করছি অ্যালকোহল কনসাম্পশনের জন্য, তাই আমি অনুমান করতাম এই ছাত্রের ফাইনাল গ্রেড ১০ বা তার কম হবে (অর্থাৎ ০)। আবার প্রোগ্রাম রান করি এবং দেখি কী হয়!
আপনার আউটপুট এইরকম দেখাবে:
Algorithm predicted class: [1] Algorithm predicted class: [0] আমাদের মডেল স্পেকট्रमের নিচে বা উপরে নম্বরগুলোতে যা এক্সপেক্ট করতাম সেটা করছে। কিন্তু এটি লড়াই করছে যখন নম্বরগুলো অপোজিট (ফ্রি ফিল করুন ভিন্ন কম্বিনেশন ট্রাই করতে -- ১ এবং ৫, বা ২ এবং ৩ উদাহরণস্বরূপ) বা মাঝপথে। আমরা আমাদের Epoch ডেটা থেকে দেখতে পাচ্ছি যে, এরর কমলেও, এটি খুব বেশি (মিড-২০%)। এর মানে হয়তো অ্যালকোহল কনসাম্পশন এবং কোর্স গ্রেডের মধ্যে কোনো রিলেশনশিপ নেই। আমি আপনাকে Kaggle-র আসল ডেটাসেটের সাথে এক্সপেরিমেন্ট করার জন্য আগ্রহ করছি -- অন্য ইনডিপেন্ডেন্ট ভেরিয়েবল আছে কি যা কোর্স আউটকাম প্রিডিক্ট করতে পারে?
র্যাপ-আপ
অনেক জটিলতা (প্রধানত ম্যাথের সাথে রিলেটেড) আন্ডার দ্য হুড ঘটে যা এই সব কাজ করাতে। আপনি যদি কৌতূহলী হন এবং আরও শিখতে চান, তবে আমি হাইলি রিকমেন্ড করছি FANN-র ডকস দেখুন বা ruby-fann জেমের সোর্স কোড দেখুন। আমি "AlphaGo" ডকুমেন্টারি Netflix-এ দেখারও রিকমেন্ড করছি -- এটাতে খুব টেকনিক্যাল নলেজ লাগে না উপভোগ করতে এবং এটি ডিপ লার্নিং কীভাবে কম্পিউটার ক্যাপাবিলিটির সীমা ধাক্কা দিচ্ছে তার একটি চমৎকার রিয়েল-লাইফ উদাহরণ দেয়।
কুর্সওয়ীল তার প্রিডিকশনে সঠিক হবেন কিনা? শুধু সময় বলবে!
