

Python Selenium-এ WebElement-এর HTML সোর্স পাওয়ার দুটি পদ্ধতি রয়েছে:
১. get_attribute('innerHTML') মেথড
s = element.get_attribute('innerHTML')
২. JavaScript Executor ব্যবহার করে
s = driver.find_element_by_id("txt-search")
driver.execute_script("return arguments[0].innerHTML;", s)
উদাহরণ ১: get_attribute ব্যবহার
from selenium import webdriver

driver = webdriver.Chrome(executable_path="C:\\chromedriver.exe")
driver.implicitly_wait(0.5)
driver.get("https://www.tutorialspoint.com/index.htm")

# এলিমেন্ট চিহ্নিত করে innerHTML বের করা
l = driver.find_element_by_css_selector("h4")
print("HTML code of element: " + l.get_attribute('innerHTML'))
উদাহরণ ২: JavaScript Executor ব্যবহার
from selenium import webdriver

driver = webdriver.Chrome(executable_path="C:\\chromedriver.exe")
driver.implicitly_wait(0.5)
driver.get("https://www.tutorialspoint.com/index.htm")

l = driver.find_element_by_css_selector("h4")
h = driver.execute_script("return arguments[0].innerHTML;", l)
print("HTML code of element: " + h)
আউটপুট
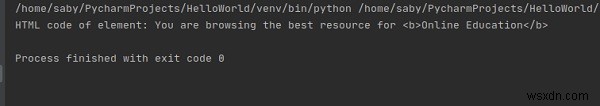
ব্যাখ্যা: `innerHTML` এলিমেন্টের শুরু এবং শেষ ট্যাগের মধ্যবর্তী HTML কন্টেন্ট রিটার্ন করে। JavaScript Executor পদ্ধতিটি জটিল সিনেরিওতে (শ্যাডো DOM, ক্রস-ফ্রেম ইত্যাদি) বেশি কার্যকর।
